Python en standard
Écosystème scikit-learn, PyTorch, parfois TensorFlow selon l’existant client. Packaging via environnements reproductibles (conda, venv, containers).
Technologies
On ne vend pas une stack miracle. On justifie chaque choix face à vos volumes, votre latence cible, votre équipe et votre politique de sécurité.
Principe
Si un modèle linéaire suffit, on ne sort pas un réseau de 200 millions de paramètres. Si votre usine n’a pas le droit de sortir une image, on ne propose pas un SaaS américain « pratique ».
La stack idéale est celle que vos ingénieurs pourront maintenir quand notre mission sera terminée. C’est un critère de sélection aussi important que la performance brute.
Modélisation
Écosystème scikit-learn, PyTorch, parfois TensorFlow selon l’existant client. Packaging via environnements reproductibles (conda, venv, containers).
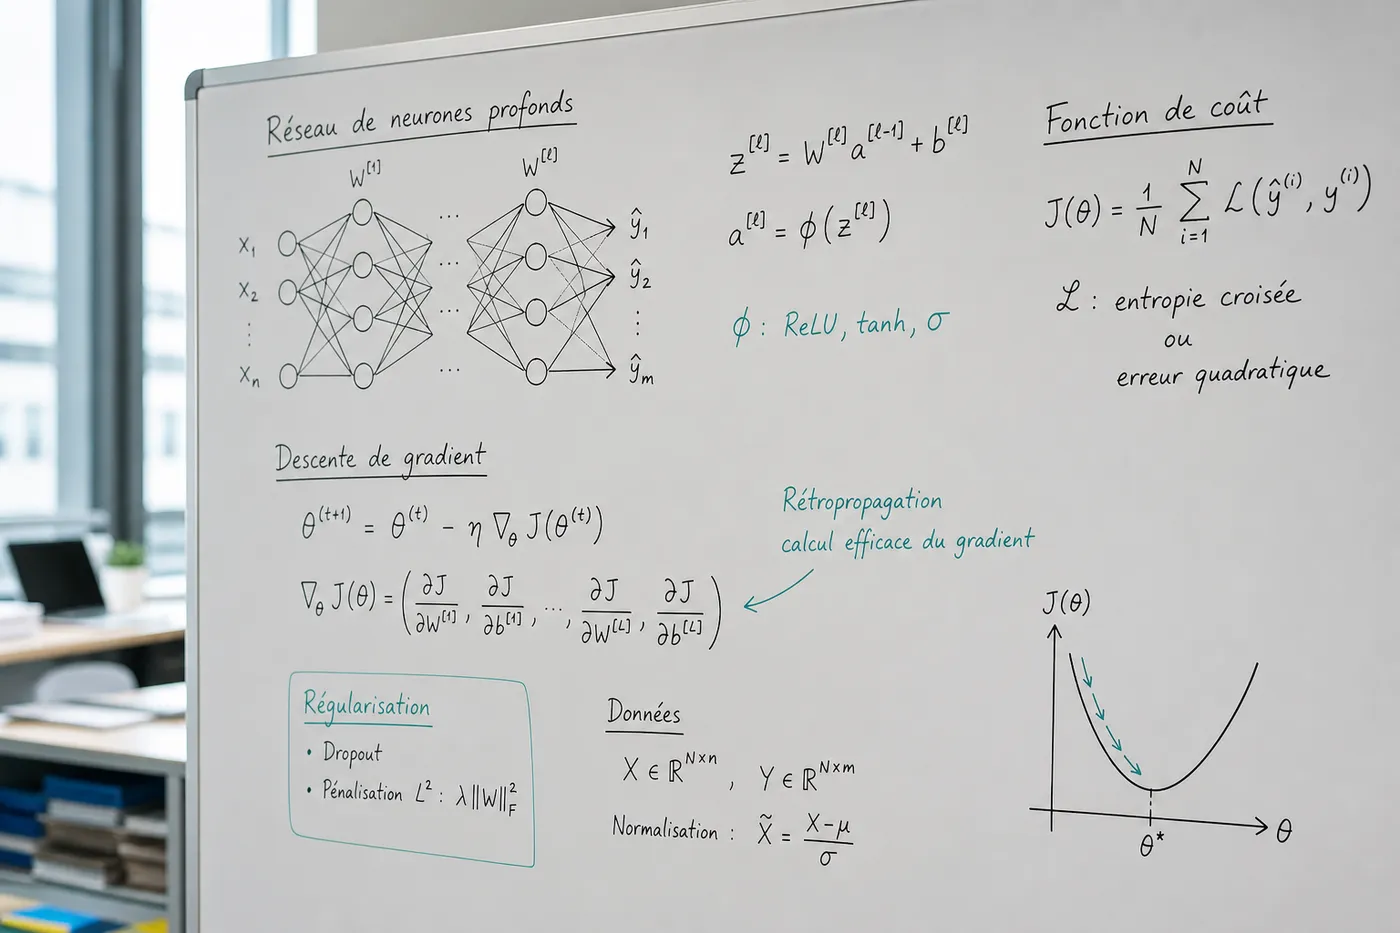
Régressions, forêts, boosting pour les baselines solides. CNN, transformers, modèles séquentiels quand le signal l’exige. Toujours une baseline simple pour juger le gain réel.
Coût d’un faux positif vs faux négatif, courbes précision/rappel, calibration. L’accuracy seule ne décide pas d’un go-live.
Utilisés pour synthèse contrôlée, assistance documentaire ou augmentation de données — jamais sans garde-fous ni journalisation des prompts/réponses en contexte sensible.
Données
Selon le cas : jobs planifiés (nuit, fin de lot) ou ingestion continue (capteurs, logs, files de messages). On documente la latence attendue et le comportement en cas de retard — un pipeline qui « rattrape » sans prévenir peut fausser un modèle.
Qui a transformé quoi, quand, avec quelle version de script. Tests sur les schémas, alertes si une colonne disparaît ou change de type. Ce n’est pas glamour ; c’est ce qui évite les incidents du vendredi soir.
SQL, entrepôts cloud, object storage, parfois bases time-series. On réutilise ce que vous avez déjà payé avant d’ajouter une brique.
Ops
Un modèle en production sans télémétrie, c’est un risque silencieux. On instrumente ce qui compte.
Code, données d’entraînement (références), hyperparamètres, artefacts. Rollback possible vers la version N-1 si la N dérive.
Tests unitaires sur les transformations, contrôles de métriques minimales avant déploiement, environnements staging / prod séparés.
Distribution des features, taux de prédiction « inconnue », latence p95. Canaux d’alerte branchés sur vos outils (mail, Slack, PagerDuty…).
API REST/gRPC, batch, parfois edge. Autoscaling quand le trafic le justifie — pas par défaut « parce que cloud ».
Confiance
Chiffrement en transit et au repos selon votre standard, gestion des secrets hors dépôt Git, comptes de service à moindre privilège, journaux d’accès exploitables en audit.
Pour les données de santé ou RH, on cadre dès le départ l’hébergement (y compris options souveraines) et les procédures de purge.